
AI 安全护栏是什么?2026 主流工具对比与四步搭建教程
AI 安全护栏(AI Safety Guardrails)是加在大模型应用输入和输出之间的一层控制逻辑,用来拦住提示词注入、敏感信息泄露、有害内容这些模型自身对齐防不住的风险。想给自己的应用加上护栏,最短路径是四步:列出风险清单、按先便宜后贵排防护层、接入开源框架或云审核 API、用真实攻击用例持续评测。下面直接给工具对比表和每一步的具体做法。
本文会讲到:
- AI 安全护栏是什么,和模型自带的对齐有什么区别
- 护栏有哪几类(官方五类分法)
- 2026 年有哪些主流工具,怎么选
- 四步搭建教程(附代码示例)
- 只靠提示词防注入靠不靠谱
- 护栏和内容安全审核的区别
- 常见问题
AI 安全护栏是什么?
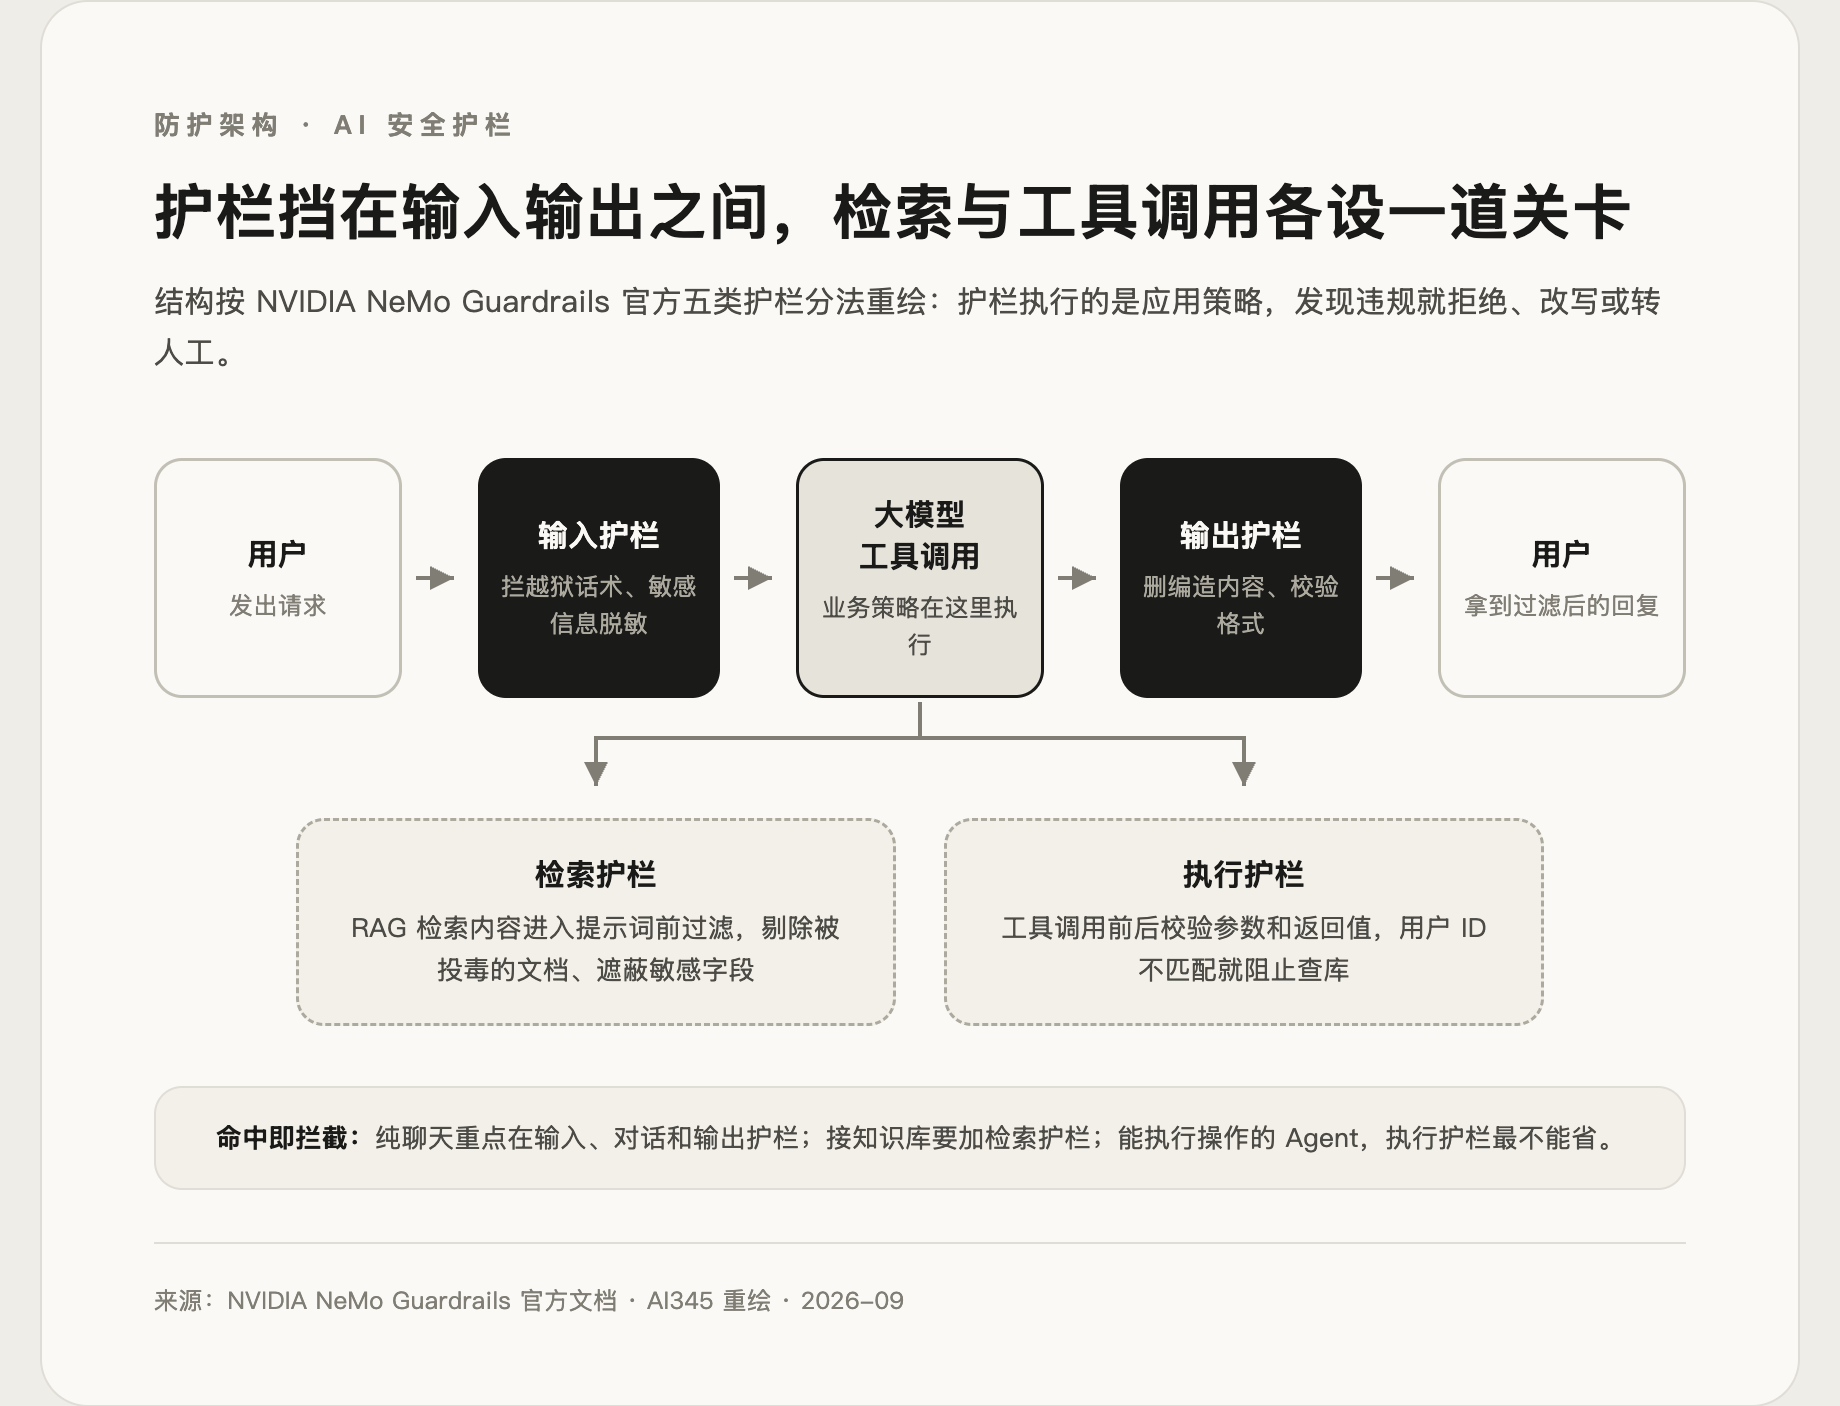
AI 安全护栏是一组位于用户和大模型之间的中间件逻辑,在内容到达模型之前、模型输出之后、以及工具调用过程中进行检查:发现违规就拒绝、改写或转人工。它执行的是你的应用策略,比如不许讨论竞品、不许输出 JSON 以外的格式、不许把用户的手机号原样传给模型。
有人会问:模型厂商不是已经做过安全对齐了吗?对齐确实挡住了大部分通用风险,但有三种情况它管不了:
- 业务规则模型不知道。你的退款政策、竞品名单、话题边界,是训练时不存在的信息。
- 对齐是概率性的。同一个越狱手法今天被拒绝,换个说法可能就绕过去了,应用方没法靠改代码修正。
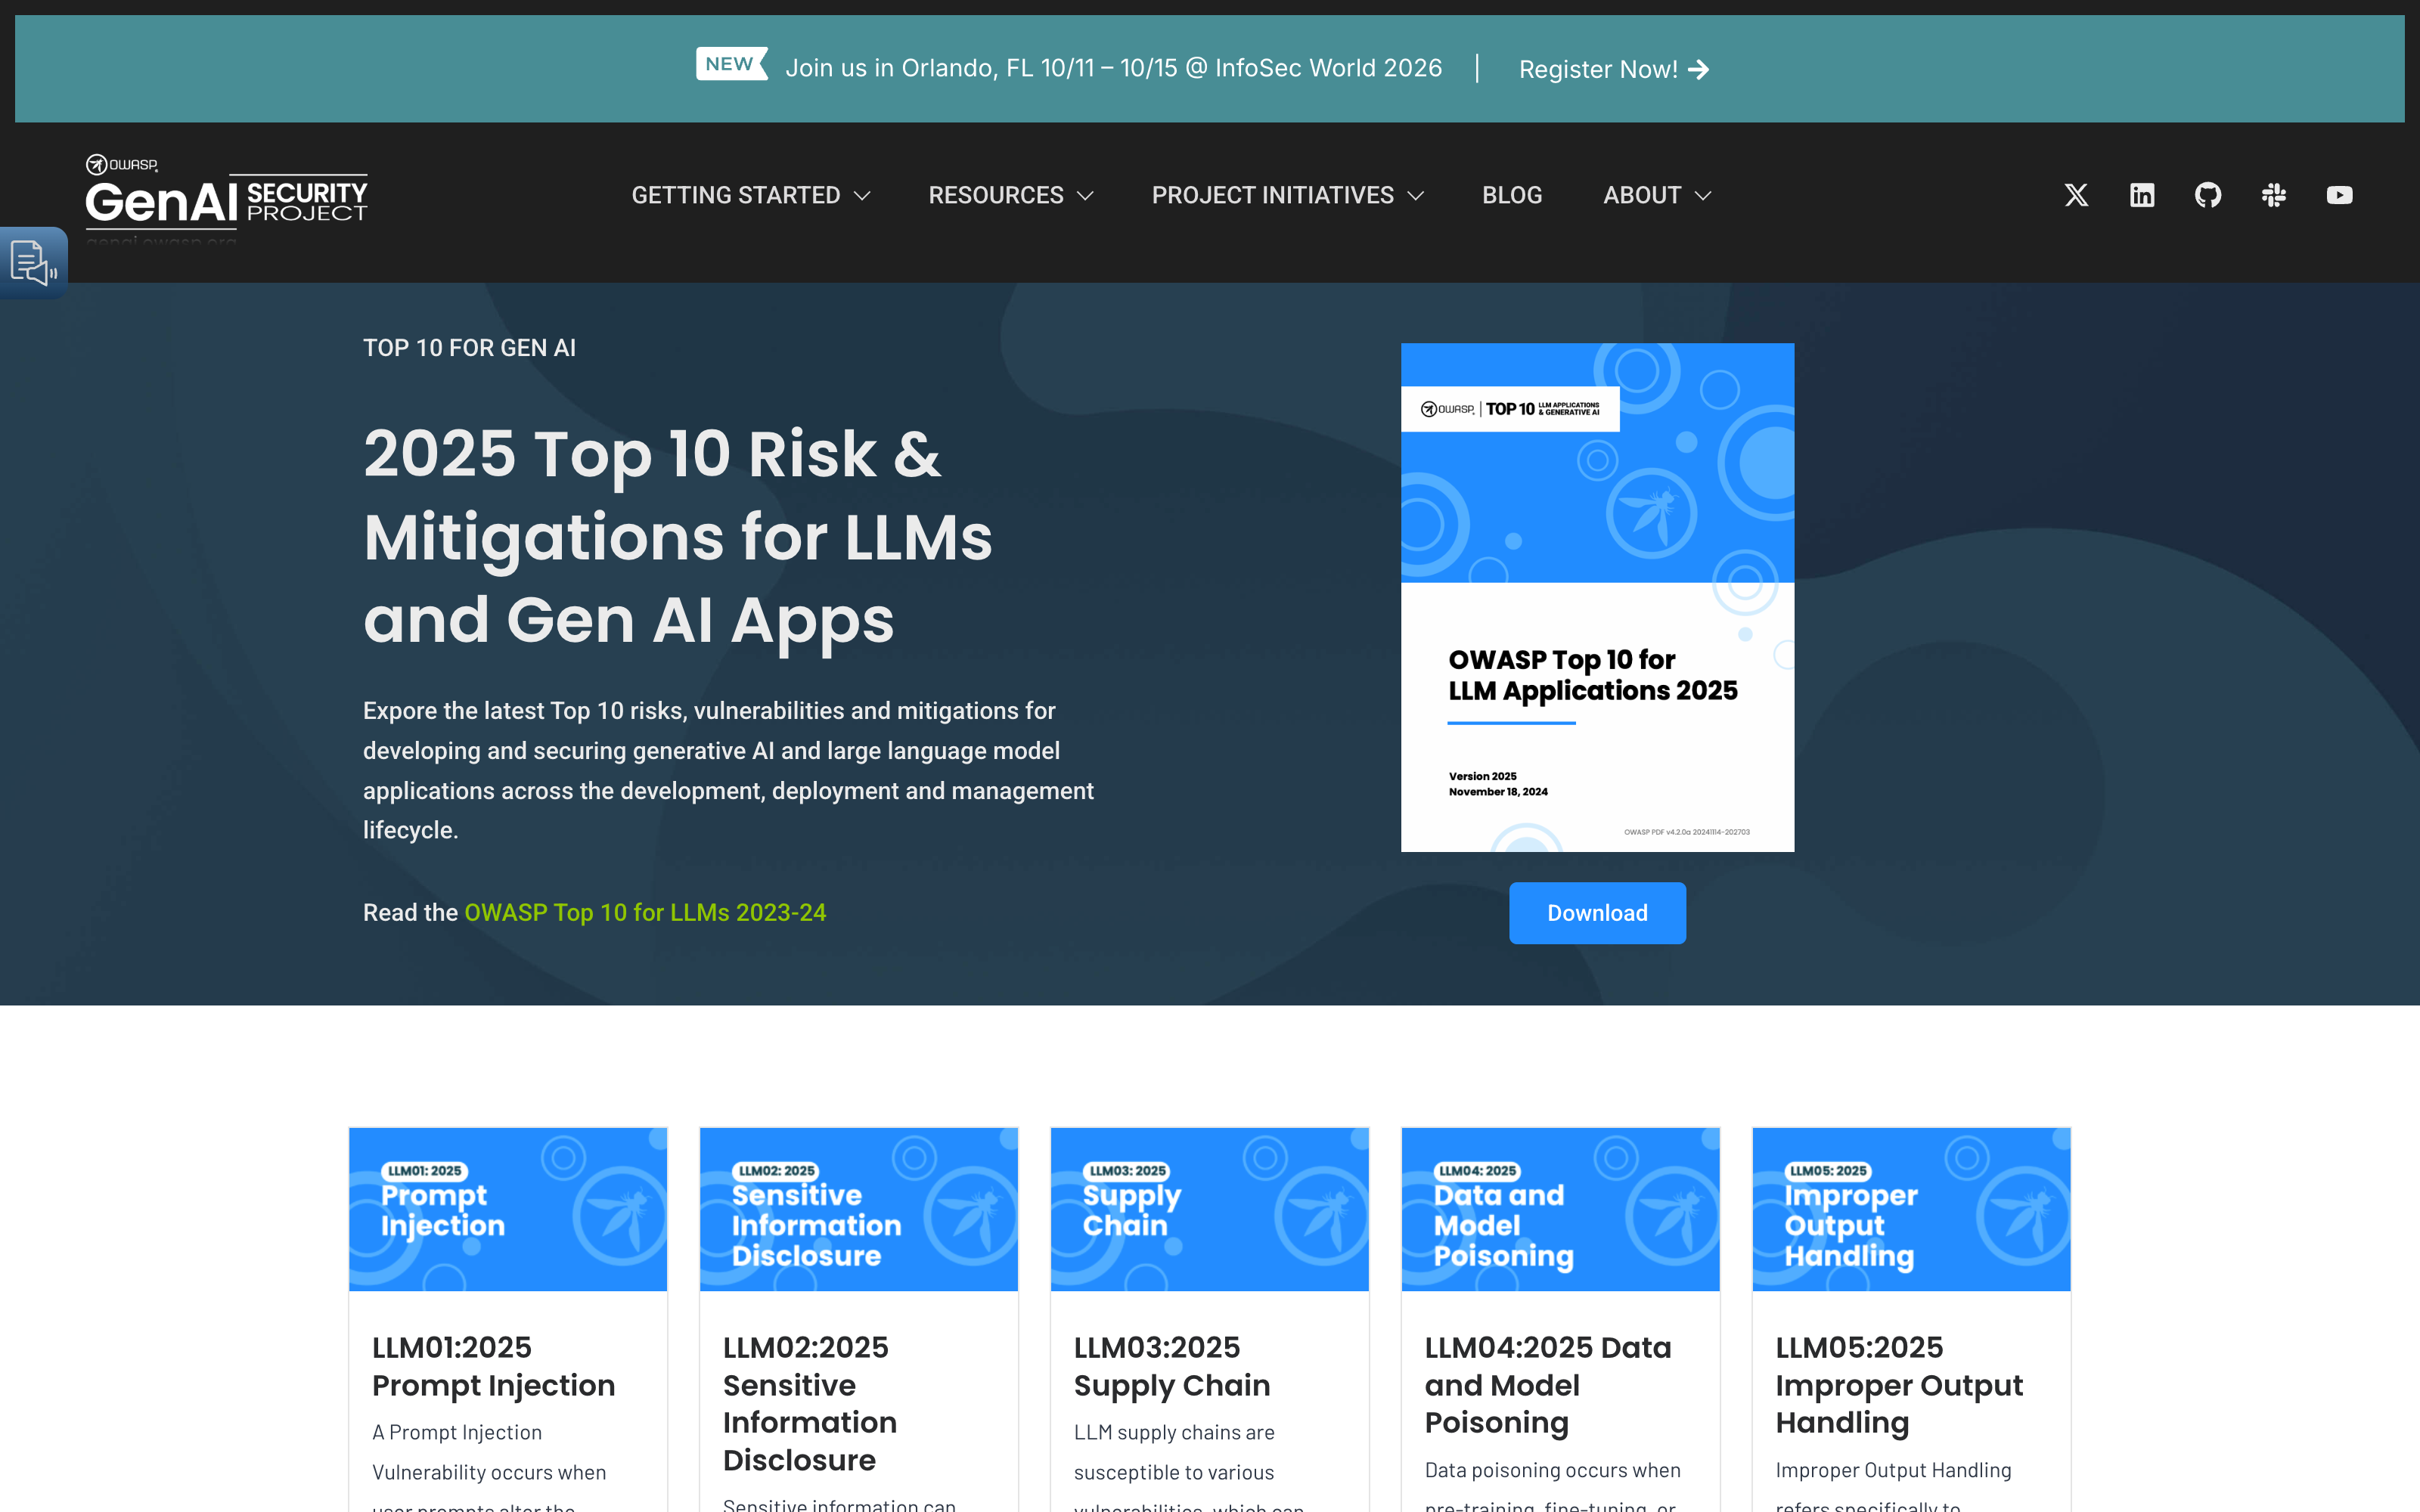
- 新攻击持续出现。OWASP 在 2025 版大模型十大风险里,把提示词注入列为第一位(LLM01),系统提示词泄露也单独上榜(LLM07),见 OWASP LLM Top 10。
护栏的价值就在于用确定性的代码逻辑补上这块短板:规则匹配该拦就拦,审计日志该记就记。
AI 安全护栏有哪几类?
NVIDIA 官方的 NeMo Guardrails 文档把护栏分成五类,这个分法比常见的三分法多覆盖了 RAG 检索和工具调用两个环节,更贴近真实应用:
| 类型 | 检查位置 | 典型作用 | 例子 |
|---|---|---|---|
| 输入护栏 | 用户消息到达模型前 | 拒绝恶意请求或改写输入 | 拦截越狱话术、给手机号脱敏 |
| 对话护栏 | 对话流程编排中 | 控制话题范围和业务流程 | 客服机器人不聊政治、按 SOP 走完身份核验 |
| 检索护栏 | RAG 检索内容进入提示词前 | 过滤检索到的知识块 | 剔除被投毒的文档、遮蔽敏感字段 |
| 执行护栏 | 模型调用工具的前后 | 校验工具参数和返回值 | 用户 ID 不匹配就阻止查库 |
| 输出护栏 | 模型回复返回给用户前 | 拒绝、修正或过滤输出 | 删掉编造内容、校验 JSON 格式 |
如果你的应用只是纯聊天,前两类和输出护栏是重点;接了知识库要加检索护栏;做了能执行操作的 Agent,执行护栏是最不能省的一层。
给大模型加护栏有哪些工具?
2026 年的工具生态可以分成三层,多数生产系统是三层组合使用,不是三选一:
| 层级 | 工具 | 开源情况 | 核心能力 | 适合谁 |
|---|---|---|---|---|
| 框架层 | NVIDIA NeMo Guardrails | 开源,Apache 2.0 协议 | 五类护栏全套,用 Colang 定义对话流,可独立部署成护栏服务器,内置越狱和注入检测 | 企业客服、需要流程控制的对话应用 |
| 框架层 | Guardrails AI | 开源,Apache 2.0 协议 | 从 Hub 安装验证器组合成输入输出防护,擅长校验和修复结构化输出 | 数据提取、对输出格式有硬要求的场景 |
| 框架层 | LangChain4j 等框架内置护栏 | 开源 | 框架自带输入输出护栏接口,支持失败重试和重新提示 | Java 技术栈,不想引入独立组件 |
| 模型层 | Meta Llama Guard 3 系列(8B / 1B / 11B 视觉版) | 权重开放,遵循 Llama 社区许可 | 专做输入输出内容审核的判别模型,对齐 MLCommons 危害分类法,支持图像和长上下文 | 想自托管审核模型的团队 |
| 模型层 | Meta Prompt Guard | 权重开放,遵循 Llama 社区许可 | 专门检测提示词注入和越狱的小模型 | 给输入侧加一道注入检测 |
| 云服务层 | Azure AI Content Safety 等云厂商内容安全 API | 商业服务 | 文本和图像有害内容审核,含提示词防护能力,开箱即用 | 不想自己维护模型、要合规背书的企业 |
几个值得注意的 2026 年动态:
- Guardrails AI 官方公告,从 2026 年 8 月 25 日起停用托管远程推理,验证器改为标准 PyPI 包直接安装,选型时按新方式接入即可。
- Guardrails AI 还维护着一个 Guardrails Index 基准,对比 24 个护栏在 6 类常见风险上的表现和延迟,选型前可以先看这份榜单。
- 主流开发框架已经把护栏做成内置能力,比如 LangChain4j 的护栏接口,说明护栏正在从独立组件变成应用框架的标配。
选型可以记三句话:要管对话流程和防跑题,选 NeMo Guardrails;要保证模型输出严格符合格式,选 Guardrails AI;只要内容审核兜底、不想自己搭,直接用云厂商审核 API 或 Llama Guard 3。
怎么给大模型应用加上安全护栏?四步搭建教程
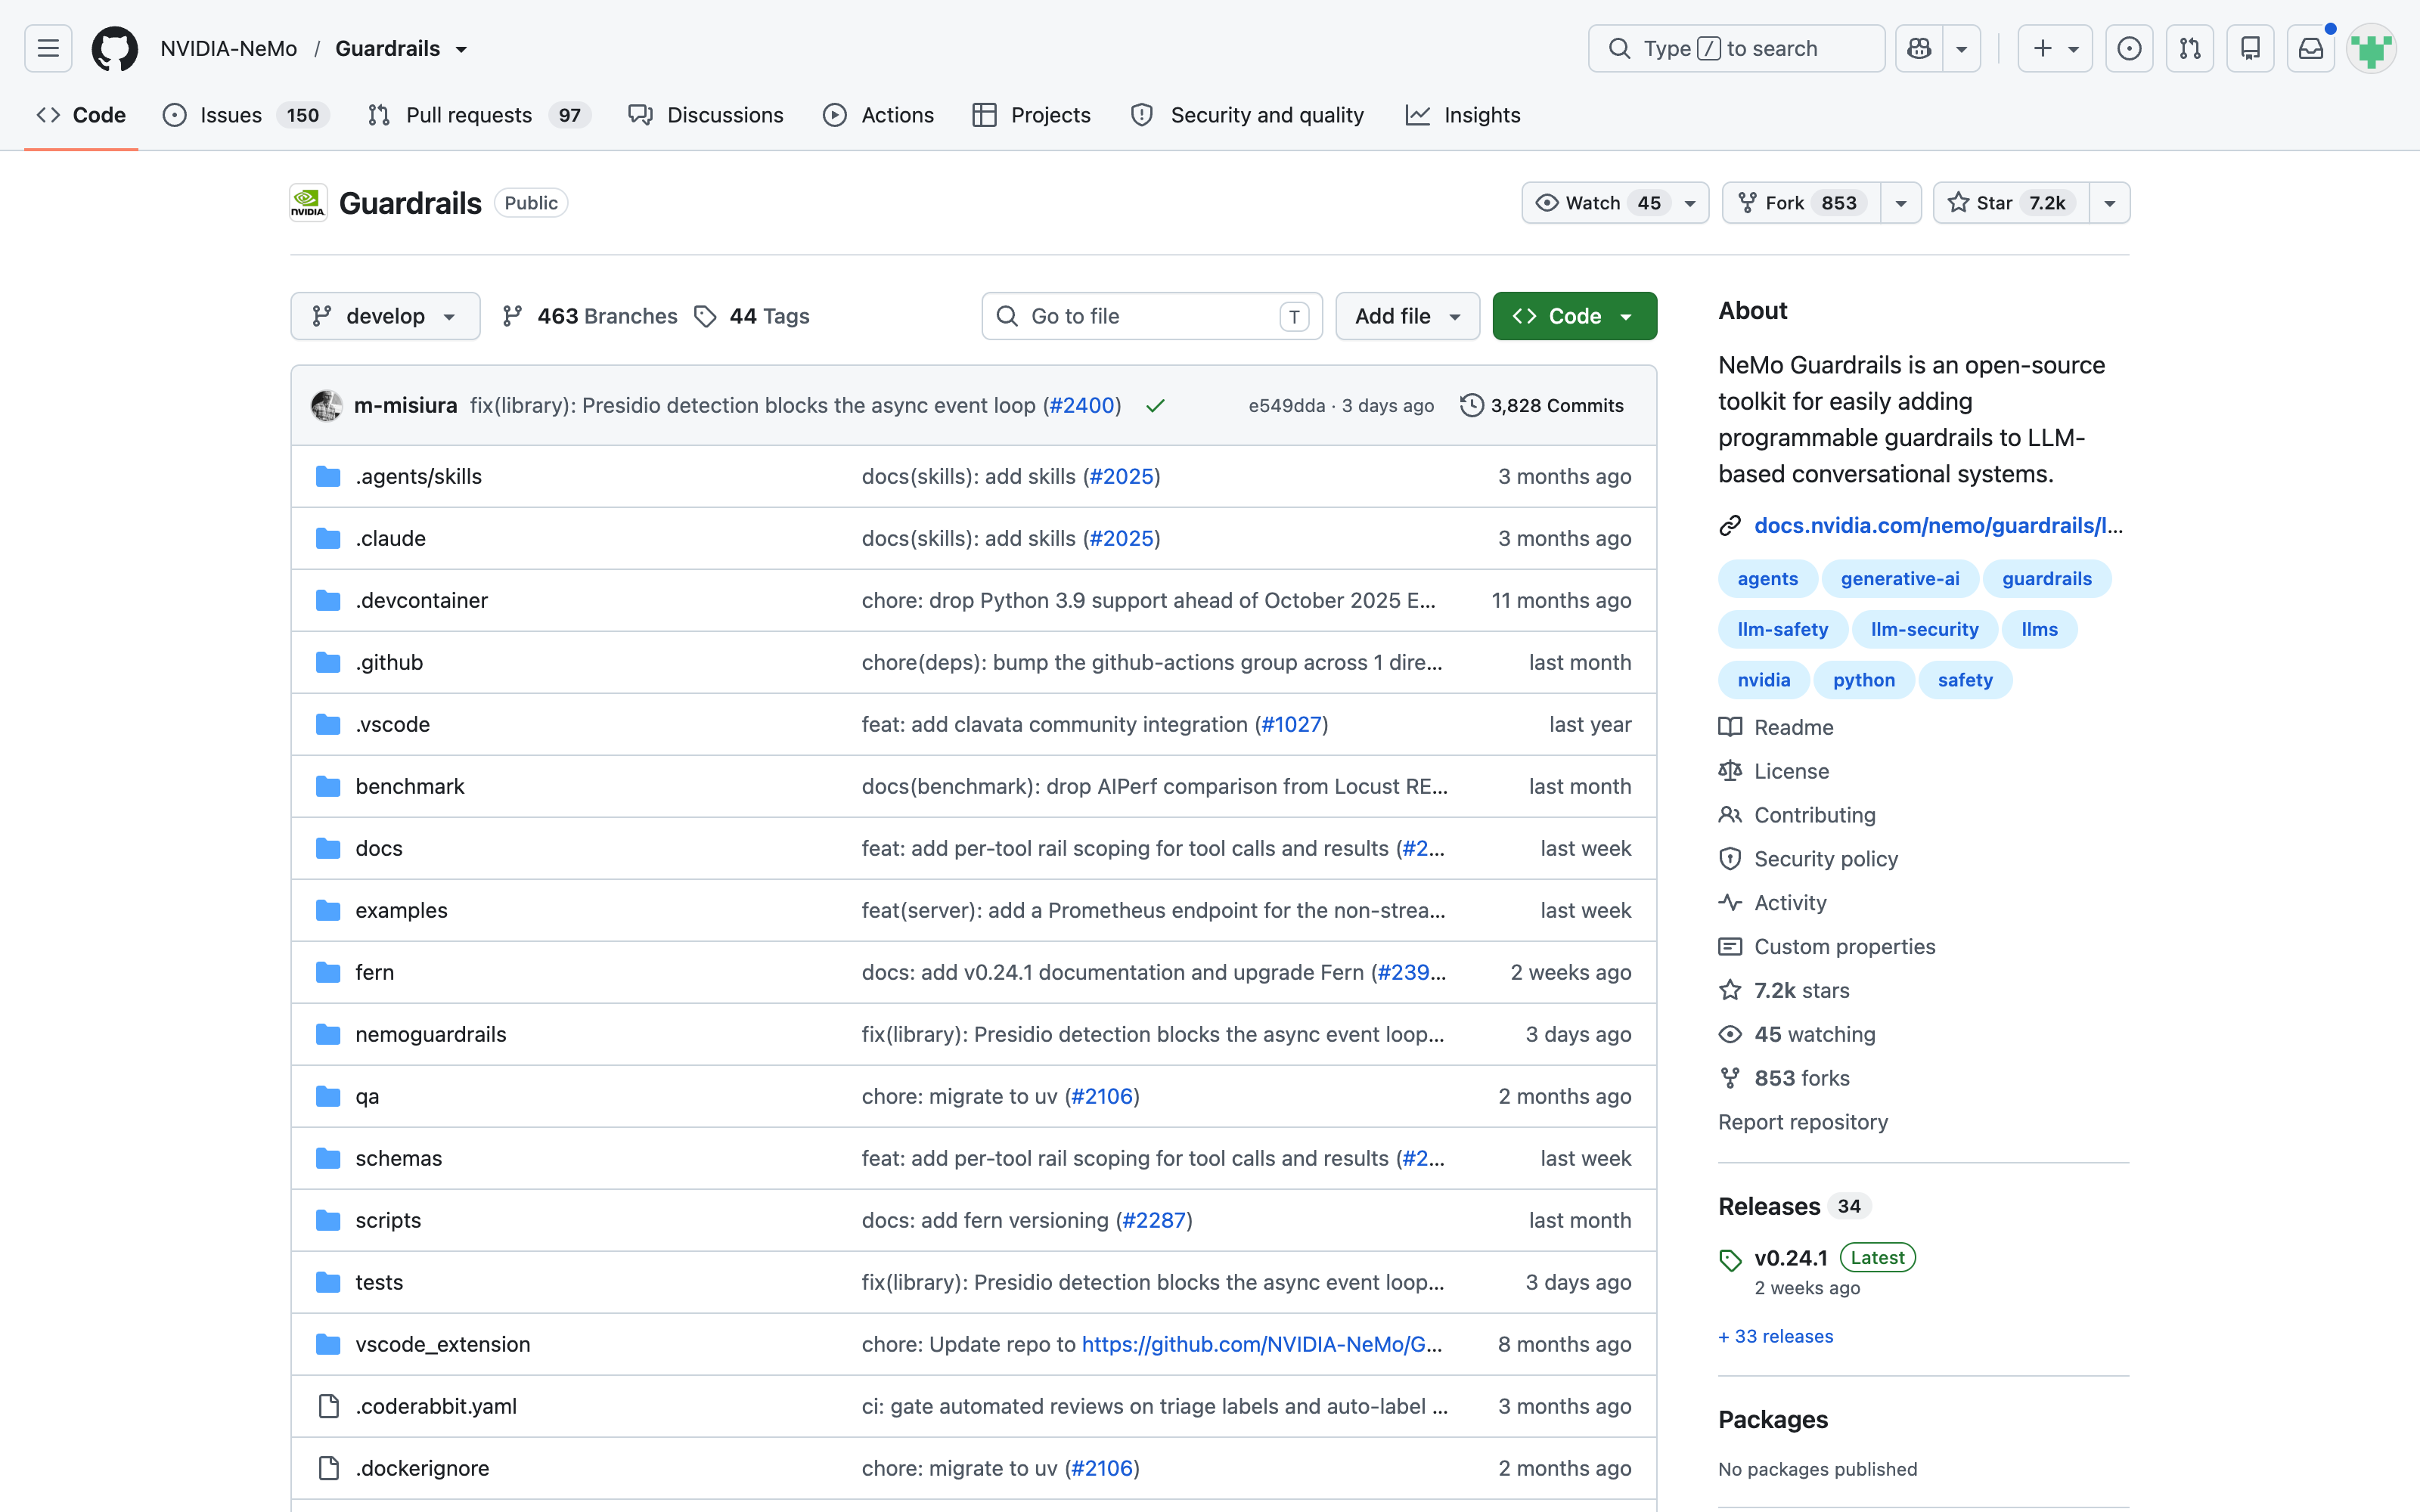
第一步:列出你的风险清单
不要上来就装工具。先拿 OWASP 2025 十大风险对照自己的应用逐条勾选:有没有把不可信的检索内容拼进提示词(注入)、会不会把用户数据发给第三方模型(敏感信息泄露)、Agent 能不能自主执行删库级别的操作(过度代理)、系统提示词被套出来损失多大(系统提示词泄露)。勾出来的项就是你要防的清单,其余的先不管,避免过度建设。
第二步:按先便宜后贵排护栏层
护栏本身有成本,排列原则是把便宜的放前面、贵的放后面,一旦前面的护栏拦截成功,后面的就不用跑:
- 规则层:正则、关键词、长度限制,延迟几乎为零,先挡掉最直白的攻击和明显违规内容。
- 判别模型层:Prompt Guard 这类小模型做注入检测,比规则准,比大模型快。
- 模型自检层:让另一个 LLM 按策略审查输入输出,最准但最贵,只留给高风险请求。
LangChain4j 官方文档给护栏链的建议也是同一个思路:最容易触发失败的护栏放前面,昂贵的护栏放链尾。
第三步:接入开源框架
以 NeMo Guardrails 为例,安装后把护栏配置加载进来,应用的调用代码只需小改:
pip install nemoguardrails
from nemoguardrails import LLMRails, RailsConfig

config = RailsConfig.from_path('./config')
rails = LLMRails(config)
completion = rails.generate(messages=[{'role': 'user', 'content': '你好'}])
配置文件里声明启用哪些护栏,比如输入侧开启越狱检测和敏感信息脱敏,输出侧开启事实核查。完整配置方法见官方文档。
如果需求是校验输出格式,Guardrails AI 的写法是从 Hub 安装验证器后组合成 Guard:
from guardrails import Guard, OnFailAction
from guardrails_ai.regex_match import RegexMatch

guard = Guard().use(RegexMatch, regex=r'\d{11}', on_fail=OnFailAction.EXCEPTION)
guard.validate('13800138000')
这段代码强制校验结果必须匹配给定正则,失败即抛异常,适合约束手机号、金额这类硬格式。完整示例见 Guardrails AI 官方文档。
第四步:评测、调阈值、留日志
护栏上线不是终点。NeMo Guardrails 自带评测命令,可以对越狱防护、输出审核、幻觉检测跑批量测试;Guardrails AI 的 Index 榜单可以当外部参照。上线后每周看一次拦截日志:误杀多就放宽阈值,漏放多就补规则。护栏太严伤正常用户体验,太松等于没装,这个平衡只能靠日志调出来。
只靠提示词防注入靠不靠谱?
很多团队的第一个护栏就是把安全规则写进系统提示词,比如禁止回答 XX 话题。这有成本低的优点,但作为唯一防线是靠不住的,原因有三个:
- 指令可以被覆盖。用户一句忽略之前的所有指令,就是在和系统提示词抢优先级,而模型的遵循是概率性的,没有硬保证。
- 间接注入更难防。攻击指令可以藏在 RAG 检索到的文档、网页内容甚至图片里,它们对模型来说和系统指令长得一样。OWASP 对提示词注入的定义明确包含利用第三方不可信数据的场景。
- 系统提示词本身会泄露。OWASP 2025 把系统提示词泄露单独列为第七大风险,把安全规则写在里面,等于把布防图贴在门上。
一个旁证是 Meta 的做法:它没有说把规则写进提示词就够,而是单独训练了 Prompt Guard 模型来检测注入和越狱。一线厂商用行动投了票。
结论:提示词防护可以当第一道软护栏,用来约束正常用户的越界行为,但对抗性场景必须配上输入检测和输出审核这类代码级防线。把系统提示词当成秘密来保护的假设,从设计上就不要做。
AI 安全护栏和内容安全审核有什么区别?
这两个词经常混用,实际是包含关系:内容审核是护栏体系里的一层,不是全部。
| 对比项 | AI 安全护栏 | 内容安全审核 |
|---|---|---|
| 目标 | 执行应用的全部策略,包括话题、格式、权限、流程 | 判定内容是否有害(暴恐、色情、违禁等) |
| 覆盖位置 | 输入、输出、检索、工具调用全链路 | 主要是文本和图像的单点判定 |
| 实现方式 | 规则、判别模型、LLM 自检和流程编排的组合 | 通常是现成的审核 API 或审核模型 |
| 提供方 | 应用方自己搭,开源框架辅助 | 云厂商提供,开箱即用 |
实际项目里的正确姿势:把云厂商审核 API(如 Azure AI Content Safety)接在输出护栏的位置上做有害内容兜底,再用自己的护栏逻辑管业务规则和工具调用。只买了审核 API 不等于有了护栏,它管不了你的竞品名单和 JSON 格式。
总结
AI 安全护栏解决的是一个很朴素的问题:模型的概率性输出和业务的确定性要求之间,需要一个能写代码的中间层。2026 年做这件事的路径已经很成熟:用 OWASP 十大风险列清单,按先便宜后贵分层接入,框架层选 NeMo Guardrails 或 Guardrails AI,审核兜底用云 API 或 Llama Guard 3,最后靠日志和评测持续调优。想先在提示词层面打好基础,可以看这篇如何向 AI 提问。
本文由 AI345 整理,最后更新于 2026 年 9 月
常见问题
AI 安全护栏会拖慢响应速度吗?
答:取决于护栏的实现方式。正则和关键词这类规则检查几乎无感,调用判别模型或让 LLM 自检会增加一次推理的耗时。通行做法是绝大多数请求只走轻量护栏,可疑流量才进重检查,整体延迟可控。
有哪些免费开源的护栏工具?
答:NVIDIA NeMo Guardrails 和 Guardrails AI 都是 Apache 2.0 协议开源,可以自由商用。Meta 的 Llama Guard 3 和 Prompt Guard 模型权重开放,但遵循 Llama 社区许可,商用前需要核对条款。
护栏能 100% 防住越狱吗?
答:不能。这是一场持续对抗,护栏的作用是抬高攻击成本并留下审计日志,让漏洞被利用时能快速发现和响应。靠分层防御加定期用新攻击用例重测,把风险压到可接受水平。
直接调大模型 API 的普通应用需要自己搭护栏吗?
答:如果只是调用大厂官方 API 做纯聊天,厂商已有的内容过滤可以兜底。但只要你的应用接了自有知识库、允许模型调用工具、或者对输出格式有硬性要求,就需要在应用层加自己的护栏,这些场景厂商的通用过滤覆盖不到。
Guardrails AI 和 NeMo Guardrails 应该选哪个?
答:核心需求是校验和修复 LLM 的结构化输出,选 Guardrails AI;需要控制多轮对话流程、防止跑题,选 NeMo Guardrails。两者不冲突,NeMo 官方也支持集成第三方审核能力,可以按层组合。
给 Agent 应用加护栏有什么特别之处?
答:除了输入输出,还要约束工具调用和权限边界。OWASP 2025 把过度代理列为十大风险之一,Agent 自主执行操作前的参数校验和权限限制,比事后过滤输出更重要。相关内容可以参考[AI Agent 是什么](/ai-guide/what-is-ai-agent)和[AI Agent 评测怎么做](/ai-guide/ai-agent-evaluation-guide)。
 京ICP备2024094994号-29